Kann eine KI, die komplett im eigenen Büro läuft, wirklich programmieren? Also nicht nur ein paar Zeilen vorschlagen, sondern selbstständig Code schreiben, Fehler finden und neue Anforderungen umsetzen – ohne dass Quellcode oder Kundendaten jemals bei OpenAI, Google oder Anthropic landen? Genau das wollte ich wissen. Deshalb habe ich drei lokale KI-Modelle auf meinem eigenen KI-Rechner gegeneinander antreten lassen.
Das Ergebnis vorweg: Ja, es funktioniert. Aber zwischen „schnell“ und „gründlich“ liegt ein Unterschied, den man kennen sollte – und der auch für dich interessant ist, wenn du KI-generierten Code auf deiner Website hast oder haben willst.
Warum ich lokale KI überhaupt teste
Ich arbeite täglich mit Kundenprojekten: WordPress-Seiten, WooCommerce-Shops, Laravel-Anwendungen. In diesem Code stecken oft Zugangsdaten, Kundendaten oder Geschäftslogik, die niemand außer mir und dem Kunden sehen soll. Cloud-KI ist praktisch, aber jede Anfrage verlässt das Haus. Für viele Aufgaben ist das vertretbar, für manche nicht.
Darum betreibe ich seit einiger Zeit einen eigenen KI-Rechner: eine ASUS Ascent GX10 mit NVIDIA-GB10-Chip und 128 GB gemeinsamem Speicher. Darauf laufen Sprachmodelle, die ich selbst herunterlade und betreibe. Keine Anfrage geht ins Internet, keine Daten verlassen das Netzwerk. Die spannende Frage: Taugt das für echte Programmierarbeit?
So habe ich getestet
Ich wollte keinen der großen öffentlichen Benchmarks nachrechnen, sondern Aufgaben, wie sie in meinem Alltag vorkommen. Die KI arbeitet dabei als sogenannter Coding-Agent in OpenCode: Sie liest Dateien, schreibt Code, führt Tests aus und korrigiert sich selbst – ganz ohne mein Eingreifen.
- Aufgabe 1 – Warenkorb-Preise: Die KI baut eine Preisberechnung mit Gutscheinen, kaufmännischer Rundung und 20 % USt. In zwei weiteren Runden kommen Mengenrabatt, ein VIP-Gutschein ab 100 Euro und das deutsche Betragsformat („1.234,56 €“) dazu. Die Anforderungen stehen nur im Chat – wie bei einem Kunden, der per E-Mail nachschärft.
- Aufgabe 2 – Buchungssystem einer Ferienwohnung: Bestehender Code mit eingebauten Fehlern. Die KI soll die Fehler finden und beheben, die Regeln stehen in einer README-Datei. Danach kommen Stornierung, eine Maximaldauer von 28 Nächten und ein Mindestaufenthalt im Sommer dazu.
Der entscheidende Kniff: Bewertet wird mit versteckten Tests, die die KI nie zu sehen bekommt. Sie laufen erst ganz am Ende. Es zählt also nicht, ob die KI ihre eigenen Tests grün bekommt, sondern ob der Code tatsächlich alle Regeln einhält. Jedes Modell hat beide Aufgaben dreimal durchlaufen, insgesamt 120 Prüfpunkte pro Modell.
Die Aufgaben, die versteckten Tests, die Skripte und alle Rohdaten habe ich offen auf GitHub gestellt. Wer eine eigene KI-Box hat, kann den Test damit selbst laufen lassen und die Ergebnisse vergleichen.
Die Ergebnisse
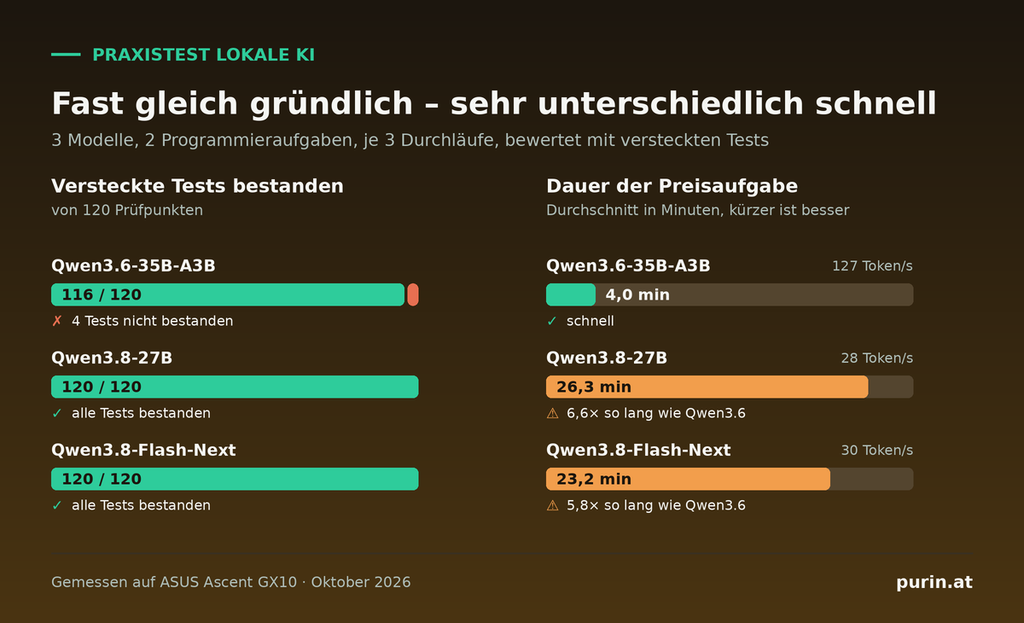
| Modell | Bestanden | Tempo (Token/s) | Ø Dauer Preise / Buchungen |
|---|---|---|---|
| Qwen3.6-35B-A3B | 116 von 120 | 127 | 4,0 / 1,8 Minuten |
| Qwen3.8-27B | 120 von 120 | 28 | 26,3 / 8,6 Minuten |
| Qwen3.8-Flash-Next | 120 von 120 | 30 | 23,2 / 10,2 Minuten |
Auf den ersten Blick ein klarer Fall: Zwei Modelle machen alles richtig, eines patzt ein bisschen. Spannend wird es aber erst, wenn man genauer hinschaut.
Der Schnelle: erledigt alles in Minuten – und übersieht eine Regel
Qwen3.6 ist ein sogenanntes Mixture-of-Experts-Modell: Es ist groß, rechnet pro Wort aber nur mit einem kleinen Teil davon. Das macht es enorm schnell. Rund 127 Token pro Sekunde sind deutlich mehr, als man mitlesen kann. Die Preisaufgabe mit drei Runden war im Schnitt nach vier Minuten fertig.
Interessant sind die vier verlorenen Punkte. Drei davon sind immer derselbe Fehler: In der README steht, dass eine Buchung mit Anreise und Abreise am selben Tag ungültig ist. Der Originalcode prüft das falsch – und die mitgelieferten Tests decken genau diesen Fall nicht ab. Das Modell hat alle sichtbaren Tests repariert, die README-Regel aber in keinem einzigen Lauf umgesetzt. Der vierte Punkt ist ein Rundungsdetail beim Mengenrabatt, das nur in einzelnen Läufen danebenging.
Das ist kein exotischer KI-Fehler, sondern genau das, was auch bei Menschen passiert: Wer nur darauf schaut, dass die Tests grün sind, übersieht Regeln, die nirgends getestet werden.
Die Gründlichen: fehlerfrei, aber mit Kaffeepause
Qwen3.8-27B und Qwen3.8-Flash-Next haben alle 120 Prüfpunkte bestanden, auch die Regel aus der README. Dafür brauchen sie spürbar länger: etwa 28 bis 30 Token pro Sekunde und für die Preisaufgabe rund 25 Minuten statt vier. Das ist rund sechsmal so lang.
Für eine Aufgabe, die ich im Hintergrund laufen lasse, während ich etwas anderes erledige, ist das völlig in Ordnung. Für schnelles Hin und Her im Dialog ist es zäh.
Was ich daraus mitnehme
- Lokale KI ist für Programmierarbeit angekommen. Alle drei Modelle haben realistische Aufgaben selbstständig gelöst, ohne dass eine einzige Zeile Code das Haus verlassen hat.
- Tempo und Sorgfalt sind ein Tausch. Für schnelle Entwürfe und Routinearbeit nehme ich das schnelle Modell, für Logik mit vielen Regeln eines der gründlichen.
- Grüne Tests sind kein Beweis. Das ist die wichtigste Erkenntnis, und sie gilt für jede KI, auch für die großen Cloud-Modelle: KI-generierter Code muss gegen die tatsächlichen Anforderungen geprüft werden, nicht nur gegen die Tests, die sich die KI selbst schreibt.
- Die Konfiguration macht viel aus. Mit der richtigen Einstellung bleibt der Zwischenspeicher bei langen Sitzungen erhalten. Eine Folgefrage bei sehr viel Kontext war damit nach 3 statt nach 55 Sekunden beantwortet. Am Ergebnis selbst hat das in meinem Test nichts geändert, an der Arbeitsgeschwindigkeit sehr wohl.
Was das für dich bedeutet
Du musst dir keinen eigenen KI-Rechner hinstellen. Aber wenn du darüber nachdenkst, KI in deinem Unternehmen einzusetzen – für Code, für Texte oder für die Arbeit mit Kundendaten – dann gibt es heute eine echte Alternative zur Cloud. Gerade bei sensiblen Daten und mit Blick auf die DSGVO ist das ein starkes Argument.
Und wenn auf deiner Website bereits Code steckt, den eine KI geschrieben hat: Lass ihn prüfen. Nicht weil KI schlecht programmiert, sondern weil sie – genau wie ein Mensch unter Zeitdruck – gern das erledigt, was überprüft wird, und den Rest übersieht.
Du willst wissen, ob lokale KI für deinen Betrieb Sinn ergibt, oder brauchst einen zweiten Blick auf KI-generierten Code? Schreib mir einfach, ich schau mir das gerne unverbindlich an.
Kurzanleitung: den Test selbst nachstellen
Für alle, die eine eigene KI-Box haben und selbst messen wollen: Alles, was du brauchst, liegt im GitHub-Repository gx10-coding-bench. Die Aufgaben, die versteckten Tests, die Skripte und meine Rohdaten sind dabei.
Das brauchst du:
- einen Modell-Server mit OpenAI-kompatibler Schnittstelle, zum Beispiel vLLM oder llama.cpp
- OpenCode (im PATH), Python 3 und Git
So gehst du vor:
- Repository klonen und in den Ordner wechseln.
- Modell-Server starten. Die genauen Startparameter für alle drei Modelle aus meinem Test stehen in der README.
- Benchmark starten. Das Skript spielt beide Aufgaben dreimal durch und bewertet am Ende mit den versteckten Tests.
- Optional das Tempo messen (Einlesen und Erzeugen von Text).
- Ergebnisse vergleichen: Jeder Lauf landet als eine Zeile in
results.jsonl, die Arbeitsordner der KI unterocruns/.
git clone https://github.com/stoffl6781/gx10-coding-bench.git
cd gx10-coding-bench

# Benchmark: 2 Aufgaben × 3 Durchläufe
python3 run_bench.py --name mein-test --upstream <host>:<port> \
  --model <modellname> --runs 3

# Tempo messen
python3 speed_test.py <host>:<port> <modellname>
Wichtig: Der Agent führt im Test selbstständig Befehle aus, ohne nachzufragen. Lass den Benchmark deshalb am besten in einer VM oder einem Container laufen und nicht auf deinem Arbeitsrechner. Wenn du eigene Ergebnisse hast, freu ich mich über ein Issue auf GitHub.
Häufige Fragen
Ist lokale KI so gut wie ChatGPT oder Claude?
Bei den ganz großen, schwierigen Aufgaben haben die Cloud-Modelle meist noch die Nase vorn. Für klar umrissene Programmieraufgaben wie in diesem Test liefern lokale Modelle aber bereits fehlerfreie Ergebnisse.
Welche Hardware braucht man dafür?
Für Modelle dieser Größe braucht es viel schnellen Speicher. Ich nutze eine ASUS Ascent GX10 mit 128 GB. Kleinere Modelle laufen auch auf einem gut ausgestatteten Laptop, dann aber langsamer oder mit Abstrichen bei der Qualität.
Wie aussagekräftig ist dieser Test?
Es sind zwei eigene Aufgaben mit je drei Durchläufen. Das zeigt klare Tendenzen, ersetzt aber keinen großen wissenschaftlichen Benchmark. Außerdem liefen nicht alle Modelle mit derselben Software und Komprimierung. Gemessen wurde im Oktober 2026 – in diesem Bereich ändert sich alles sehr schnell.
Kann ich den Test selbst durchführen?
Ja. Alles liegt im GitHub-Repository gx10-coding-bench, inklusive Anleitung und der genauen Server-Einstellungen. Du brauchst einen Server mit OpenAI-kompatibler Schnittstelle (zum Beispiel vLLM oder llama.cpp), OpenCode und Python. Neue Ergebnisse oder zusätzliche Aufgaben nehme ich gerne entgegen.
Quellen und Werkzeuge
- gx10-coding-bench auf GitHub – Aufgaben, versteckte Tests, Skripte und Rohdaten zu diesem Test
- OpenCode – Open-Source-Coding-Agent, mit dem die Modelle gearbeitet haben
- vLLM und llama.cpp – die Server, auf denen die Modelle liefen
- Qwen3.6-35B-A3B (NVFP4) auf Hugging Face
- Qwen3.8-27B (NVFP4) auf Hugging Face
- Qwen3.8-Flash-Next (GGUF) auf Hugging Face